Understanding rMATS:可变剪接异构体比例的分层统计建模与差异推断
Understanding rMATS:可变剪接异构体比例的分层统计建模与差异推断
.
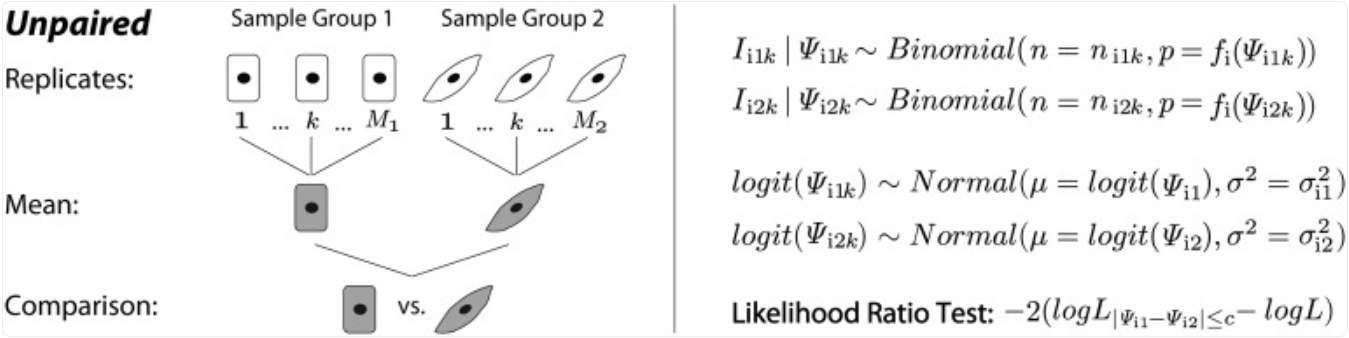
rMATS(multivariate analysis of transcript splicing)的计算模型与算法思路,核心在于解决一个矛盾:也就是所要检测的两种剪接isoform之间的真实比例,但测序数据同时受到isoform长度差异和随机抽样噪音的干扰,因此,rMATS构建了一个分层统计模型,在单样本层面用二项分布处理测序噪音,在组间层面用logit-正态分布来处理生物学重复间的变异,并通过将有效长度校正嵌入二项分布的概率参数计算中,来估计真实的剪接包含水平。
————————————————————————————————————————————————
————————————————————————————————————————————————
.
在上一篇(Understanding rMATS: 基于 Junction Reads 的剪接Inclusion水平(PSI/ψ)估计)中,已经介绍了用于估算剪接inclusion水平的ψ值。
.
But,这里需要注意一下的是,上面所计算出来的这个ψ值,是一个确定性的计算结果(只是一个点估计)。而测序数据是充满随机性的,你不知道这个ψ值是因为你测了 10000 条 read 得到的(极度准确),还是因为只测了5条 read 得到的(纯属偶然)。所以,这里需要用概率模型(这里使用的是二项分布)对这种测序过程中的随机性进行评估,也就是给数据加一个置信区间——就像对尺子测得准不准做了一个判断。
.
单样本的二项分布模型
rMATS 统计学原理中最精妙、也最容易让人困惑的地方在于:它并没有先用公式算出一个ψ值,再去做统计;相反,它直接假设“观测到的reads”服从某个概率分布,然后利用这个分布反推ψ值。
很多人的惯性思维:肯定是先用前面的公式算出一个数值,然后拿这个数去做T检验或方差分析。但 rMATS 并不是这样做的。
rMATS 的逻辑是:第一步,大自然是先有一个真实的剪接比例ψ值(比如真实的inclusion level是0.6);然后,测序仪在这个真实的ψ值下,随机抽取 read,由于是随机抽取,观测到的I(inclusion reads)和S(exclusion reads)会围绕真实比例波动。rMATS 用二项分布来描述这种波动。
.
假设在真实ψ情况下,测序仪随机抽取reads的过程服从二项分布,但关键在于,单次抽样抽到包含型(exon inclusion isoform)read的概率 p,不是直接的ψ,而是被有效长度加权后的值:
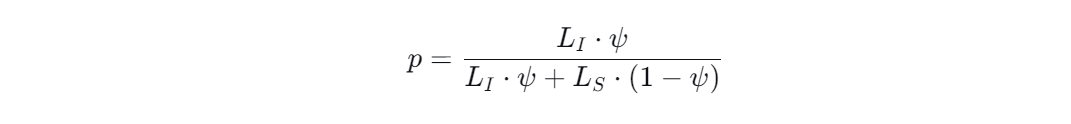
然后,包含型(exon inclusion isoform)的read数 I 服从下面二项分布模型:
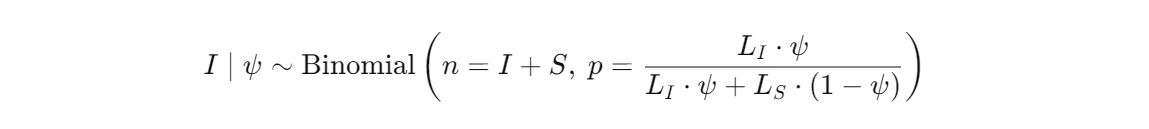
这个模型的意义在于:它通过二项分布的性质,为每个样本中估计出的 ψ 附带了一个方差值,衡量了测序深度带来的抽样不确定性。
.
总结一下:rMATS 的底层逻辑是“先假设真实ψ存在→ 结合长度权重得到抽样概率 p → 测序仪抽样服从二项分布 → 用观测数据反向推测最可能的 ψ。
.
.
跨样本的分层模型
得到每个样本的 ψ 值及其方差后,rMATS 需要比较两组样本(如处理组 vs 对照组)的差异。但不同生物学重复之间的真实 ψ 本身也存在波动,不能把组内所有波动都归咎于测序噪声。
rMATS 因此构建了一个分层模型:在单样本的二项分布的基础上,假设每个样本的 ψ(经过 logit 变换后)服从一个正态分布,其均值为该组的平均剪接水平,而方差代表的则是组内的生物学变异。
对于非配对设计,其模型形式为:
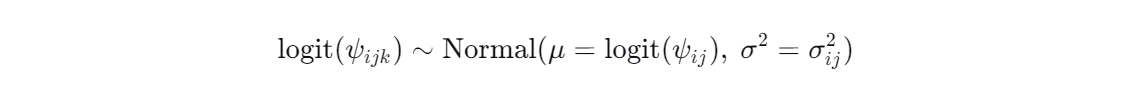
i:代表某个特定的可变剪接事件(如某个特定的 Exon Skipping 事件)。
j:代表实验分组(比如:对照组)。
k:代表该组内的第 k 个样本(比如:对照组里的第 3 只小鼠)
ψijk *(Psi)**:就是前面提到的 Inclusion Level(剪接包含率)。即单个样本 k 在该事件 i 上的观测值。
logit():对数几率转换。因为 ψ 是一个 0 到 1 之间的比例,直接做正态分布假设不合适(比如比例不可能小于0或大于1)。经过 logit 转换后,数值范围变成 (−∞,+∞)(−∞,+∞),就可以正常地使用正态分布和线性模型了。这样,rMATS 就可以算出一个组的均值(μ)和方差(σ2)。
logit() 函数就像一个拉伸器,把原本死死卡在 0 和 1 之间的比例,均匀地拉伸到了整个实数轴上(负无穷到正无穷)。
.
.
带效应量阈值的假设检验
rMATS 最终的统计检验目标,不是检验“两组 ψ 是否相等”(即 Δψ=0),而是引入了一个由用户通过 -c 参数(默认极小值,如 0.0001)设定的边界 c。其原假设为:两组 ψ 的绝对差异不超过c(H0: ∣Δψ∣≤c);备择假设为差异大于c(H1: ∣Δψ *>*c)。这种设计是为了避免在极高测序深度下,极微小的随机波动被错误地判定为具有统计学意义的显著差异。-c 是模型检验参数(用来划定原假设边界)。
.
rMATS算法通过构建包含二项分布(技术噪声)和正态分布(生物学变异)的联合似然函数,进行似然比检验,进而计算出每个事件的 P 值。由于全基因组范围内检验的事件数量极其庞大(数万至数十万),rMATS 最终会对所有 P 值进行 Benjamini-Hochberg 多重检验校正,并输出 FDR(控制假阳性率)。
.
P值是怎么算出来的?(似然比检验)
这是 rMATS 算法的核心。
P 值不是套公式直接算出来的,而是通过比较两个模型的“拟合优度”得出的。
.
rMATS 把单样本的“二项分布”和组内的“正态分布”乘在一起,形成一个巨大的似然函数 L,也就是构建联合似然函数。
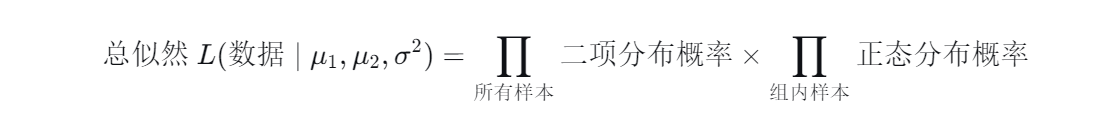
然后建立两个相互竞争的假设(模型):
原假设(H0):两组没有显著差异(差异不超过阈值c),即∣μ1−μ2∣≤c。rMATS 在强制满足这个条件的前提下,去寻找能让总似然函数 L 最大的参数组合,算出来的最大似然值记为L0 。
.
原假设(H1):两组有显著差异,即∣μ1−μ2| > c,rMATS 解除限制,在整个空间里寻找能让总似然函数 L 最大的参数组合。算出来的最大似然值记为L1 。
.
计算似然比 (Likelihood Ratio):
显然,因为没有限制,L1一定会大于或等于L0,计算它们的比值:
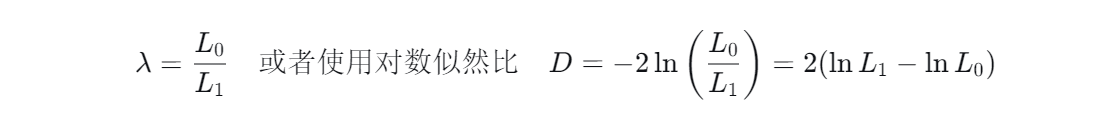
(注:D 也被称为偏差统计量 Deviance)。
如果 L1 比 L0大很多,说明“允许有差异”极大地提升了模型的解释力,则D值会很大。
如果 L1 比 L0差不多,说明“允许有差异”对模型没啥帮助,则D值会接近0。
.
转换为 P 值:
根据统计学理论(Wilk’s Theorem),在大样本下,这个统计量 D服从卡方分布(X2分布),其自由度取决于两个模型的参数差异(通常是 1)。
rMATS 利用这个卡方分布,计算出 “如果原假设是真的,我有多大偶然性能够观测到这么大的D值?”
这就得出了我们熟悉的 P 值。
如果 P 值很小(比如 P<0.001),说明在“没有差异”的前提下,几乎不可能出现这么高的似然比,所以我们拒绝原假设,认为存在显著差异。